L102 二叉树的层序遍历
题目链接
https://leetcode.cn/problems/binary-tree-level-order-traversal/description/
题目描述
给你二叉树的根节点 root ,返回其节点值的层序遍历(即逐层地,从左到右访问所有节点)。
示例
示例 1
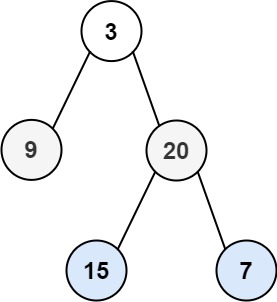
输入: root = [3,9,20,null,null,15,7]
输出: [[3],[9,20],[15,7]]
示例 2
输入: root = [1]
输出: [[1]]
示例 3
输入: root = []
输出: []
提示
- 树中节点数目在范围 内
题解
这道题要求我们按照从上到下、从左到右的顺序,一层一层地遍历二叉树。
这种遍历方式其实就是非常经典的 BFS(Breadth First Search,广度优先搜索)。
这一圈一圈向外扩散就行了:先处理当前层的所有结点,再处理下一层。看题目中的示例 1,很好理解,直接先处理一层,然后处理下一层……那这个如何实现?用队列 Queue!
我们先把根结点放入队列,之后每次就从队首取一个结点处理,然后把它的左右子节点放到队尾就行了。由于队列先进先出,所以当前层的结点会被优先处理,接着下一层,依次处理。
本题除了要按照 BFS 顺序遍历,还需要最终输出一个 vector<vector<int>>,所以就需要把每一层的结点拼成一个小 vector<int>,最后再拼接到 vector<vector<int>> 返回。
那关键问题就变成了:如何知道当前这一层到底有多少个结点?我一开始是额外维护每一层的结点数量(看后面第一段代码),后来发现其实根本不用这么麻烦——每次开始处理新的一层时,当前队列中的结点数量刚好就是这一层的结点数量。
在看代码之前,先简单认识一下这里要用到的 STL 容器 queue。
| 功能 | 示例代码 | 备注 |
|---|---|---|
| 创建 | queue<int> q; | 创建一个空队列 |
| 入队 | q.push(1); | 将元素添加到队尾 |
| 出队 | q.pop(); | 移除队首元素,不返回该元素 |
| 访问队首 | q.front() | 返回队首元素,不移除 |
| 访问队尾 | q.back() | 返回队尾元素,不移除 |
| 判空 | q.empty() | 队列为空返回 true,否则返回 false |
| 元素个数 | q.size() | 返回队列中元素的数量 |
这个是我刚开始的写法,自己维护每一层的结点数量(这个写法不是很好,简单看看就行,不用深入研究):
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution
{
    public:
        vector<vector<int>> levelOrder(TreeNode* root) // 还需要保留层数信息,试试每一层创建一个队列?太麻烦了,记录每一层的数量吧
        {
            queue <TreeNode*> nodequeue; // 创建结点队列
            vector <int> levelsize; // 维护每一层的结点数量

            nodequeue.push(root); //把头结点放入队列
            levelsize.push_back(1); //把第0层大小设置为1

            vector <vector <int>> ans; //返回结果
            vector <int> ans_level; //每一层的结果

            if(root == nullptr) //根结点为空的情况
                return ans;

            int i = 0; //表示层数

            while(!nodequeue.empty()) // 队列不为空就循环,i 表示层数,初始为第0层
            {
                TreeNode *now_node = nodequeue.front(); //取队首
                nodequeue.pop(); //出队

                ans_level.push_back(now_node->val); // 当前结点值放入本层结果

                if(now_node->left) //存在左子结点
                {
                    nodequeue.push(now_node->left); //入队

                    //下一层计数
                    if(i == levelsize.size() - 1) //如果不存在下一层
                        levelsize.push_back(1); //创建下一层并初始化为1
                    else
                        levelsize[i+1]++;

                }
                if(now_node->right) //存在右子结点
                {
                    nodequeue.push(now_node->right); //入队

                    //下一层计数
                    if(i == levelsize.size() - 1) //如果不存在下一层
                        levelsize.push_back(1); //创建下一层并初始化为1
                    else
                        levelsize[i+1]++;
                }

                levelsize[i]--; //当前层的数量减一
                if(levelsize[i] == 0) //这一层已经全部处理完了,则可以开启下一层
                {
                    ans.push_back(ans_level); //把这一层的结果放回到输出结果中
                    ans_level.clear();

                    if(i == levelsize.size() - 1)//如果没有下一层了
                        break;

                    else //如果存在下一层
                        i++;
                }
            }

            return ans;
        }
};
这份代码的基本思路没有问题:先创建一个结点队列 nodequeue,同时再使用一个 levelsize 数组记录每一层还有多少个结点没有处理。
每处理一个当前层结点,就执行:levelsize[i]--; 如果发现 levelsize[i] == 0,说明这一层已经全部处理完成,就把当前层结果 ans_level 放入最终结果 ans 中,然后开始处理下一层。
同时,每当发现当前结点存在左子结点或者右子结点时,不仅要把子结点放入队列,还需要维护下一层的结点数量。
这种方法确实可以完成题目,但是写下来会发现:为了知道当前层还有多少个结点,我们额外维护了一个 levelsize,并且每加入一个子结点都要更新它,逻辑明显有点绕。
因此可以用刚刚说的"当前队列中的结点数量刚好就是这一层的结点数量"来完成:
class Solution
{
    public:
        vector<vector<int>> levelOrder(TreeNode* root)
        {
            vector <vector<int>> ans; //返回结果
            if (!root) return ans;  //考虑头结点为空

            queue <TreeNode*> nodequeue; //创建结点队列
            nodequeue.push(root); //放入头结点

            while (!nodequeue.empty()) //结点队列不为空,则遍历队列
            {
                int sz = nodequeue.size(); //sz保存当前队列长度,每一次while都是新的一层,因此也是本层的数量
                vector <int> ans_level; //当前层的结果

                for (int i = 0; i < sz; i++)
                {
                    TreeNode* now_node = nodequeue.front(); //取队首
                    nodequeue.pop(); //出队
                    ans_level.push_back(now_node->val); //放回返回结果

                    if (now_node->left)  nodequeue.push(now_node->left);
                    if (now_node->right) nodequeue.push(now_node->right);
                }
                ans.push_back(ans_level);
            }
            return ans;
        }
};
这份代码就简洁多了。首先创建最终的二维数组 ans 用来保存每一层的遍历结果,然后考虑根结点为空的情况(直接返回空数组即可),接着创建结点队列 nodequeue,并先把根结点放进去。
接下来进入 while 循环,只要队列不为空,就说明还有结点没有处理。这里最关键的就是 int sz = nodequeue.size();,每次刚进入新一轮 while 时,队列中保存的刚好就是当前这一层的所有结点,因此此时的队列长度 sz 就是当前层的结点数量。
在 for 循环中,每次先通过 front() 取得队首结点,再通过 pop() 将其出队,然后把当前结点的值加入 ans_level。如果这个结点存在左右子结点,就继续将它们加入队尾,等到下一层再进行处理。
等 for 循环结束,就说明当前层已经全部遍历完成,此时把 ans_level 加入最终结果 ans。然后开始下一轮,现在队列中剩下的刚好就是下一层的全部结点。
于是整个 BFS 的过程就变成了:每轮先记录当前层有多少个结点,把这一层全部出队处理,同时把它们的子结点加入队列,留给下一轮继续处理。一直循环到队列为空,整棵二叉树也就遍历完成了。
这道题我也借助 AI 补充了力扣提交代码之外的本地测试部分,可以直接在自己的编译器中输入数据并运行。完整代码已经整理到 GitHub:https://github.com/C571467648/blog。其他题目也是采用相同的方式整理,建议有需要的话一次性下载使用。如果觉得比较麻烦,或者只想研究题目本身,也可以直接在力扣平台研究 class Solution 部分的代码。
本题讲解就到这里啦,欢迎交流讨论~
本文内容主要来自个人学习与实践总结,受限于个人技术水平,难免存在理解不准确或表述疏漏等错误。 若您发现问题,或愿意就相关内容进一步交流,欢迎通过邮箱 571467648@qq.com 与我联系。感谢您的阅读与指正。